
Vom Klick zur Pipeline: reproduzierbare VM-Templates
Eine VM installieren, Updates einspielen, Einstellungen anpassen und zum Template konvertieren: So beginnen viele Proxmox-Umgebungen. Der Ablauf funktioniert. Schwierig wird es, wenn Monate später nachvollzogen werden soll, wie dieses Template entstanden ist.
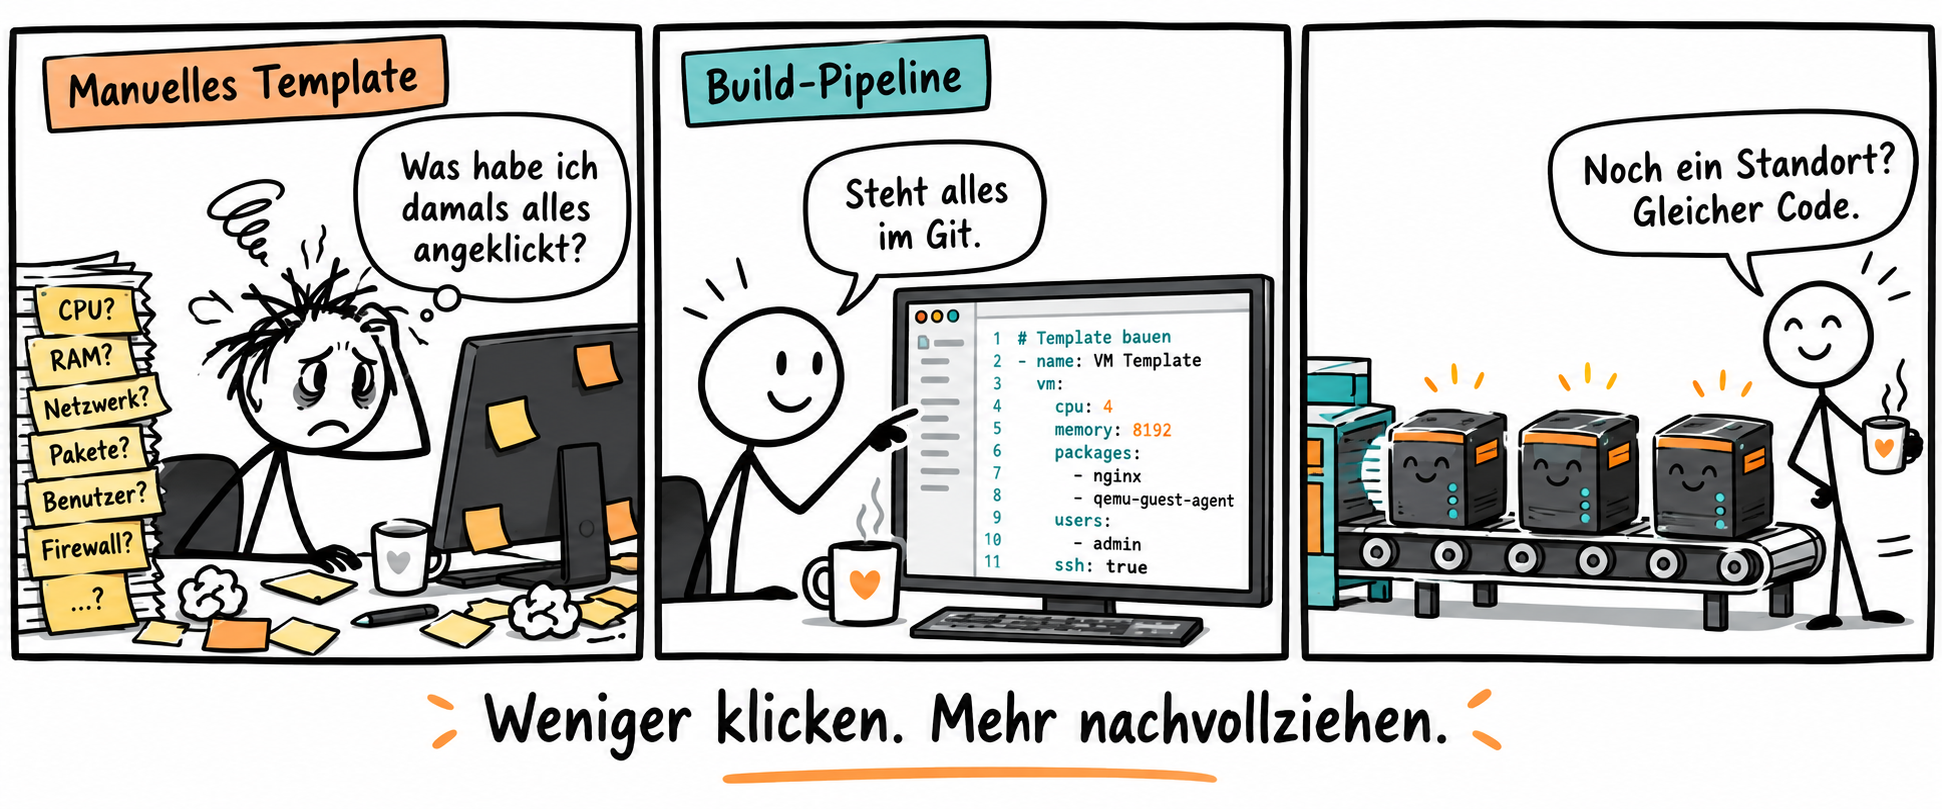
Welche Updates waren installiert? Welche Härtung wurde umgesetzt? Wurde die letzte Änderung auch am zweiten Standort übernommen?
Ein manuell gepflegtes Template zeigt den fertigen Zustand. Die Schritte dorthin bleiben oft in Dokumentationen, Shell-Historien oder den Köpfen einzelner Administratoren verteilt. Eine Build-Pipeline macht diese Schritte zum überprüfbaren Bestandteil der Infrastruktur.
Templates aus Code
Die Grundlage bildet HashiCorp Packer. Aus einem Cloud-Image oder einer Installations-ISO entsteht über definierte Provisionierungsschritte ein fertiges Proxmox-Template. Installation, Updates, Grundkonfiguration und Bereinigung laufen automatisiert.
Das hier vorgestellte Projekt umfasst Ubuntu 24.04, Debian 13 sowie Windows Server 2019, 2022 und 2025. Für Windows gibt es zusätzlich eine Variante mit einer kuratierten CIS-Level-1-Baseline.
Die Build-Definitionen folgen einer gemeinsamen Struktur:
builds/
├── ubuntu-2404/
├── debian-13/
└── windows-server/
Jede Familie enthält Variablen, eine Definition der Quelle und virtuellen Hardware sowie die Provisioner-Kette mit den zugehörigen Skripten. Änderungen lassen sich dadurch versionieren und reviewen: Ein Diff zeigt beispielsweise, wann eine TLS-Einstellung angepasst oder ein zusätzlicher Dienst installiert wurde.
Gemeinsame Abläufe, getrennte Cluster-Konfiguration
Die Build-Logik bleibt unabhängig vom Zielcluster. Standortabhängige Einstellungen wie API-Adresse, Storage und VLAN liegen in eigenen Variablendateien. Zugangsdaten werden separat bereitgestellt und nicht im Repository gespeichert.
Eine Cluster-Konfiguration kann beispielsweise so aussehen:
proxmox_url     = "https://pve01.example.net:8006/api2/json"
storage_pool    = "local-zfs"
network_vlan_tag = 42
Der Build wird über einheitliche Make-Ziele gestartet:
make ubuntu CLUSTER=standort-a
make win2022 CLUSTER=standort-b
Die Templates entstehen jeweils im Zielcluster. Ein fertiges Template muss damit nicht zwischen Standorten kopiert werden. Beide Standorte verwenden dieselbe Build-Logik mit ihren jeweiligen Parametern.
Das schafft eine gemeinsame Grundlage, garantiert aber noch keine identischen Ergebnisse: Unterschiedliche Basis-Images, Paketstände oder Build-Zeitpunkte können Abweichungen verursachen. Für nachvollziehbare Builds sollten deshalb Git-Commit, Quell-Image, Prüfsumme und verwendete Werkzeugversionen dokumentiert werden. Wer identische Paketstände benötigt, muss zusätzlich die Paketquellen kontrollieren.
Linux: schlanke Cloud-Images als Ausgangspunkt
Ubuntu und Debian werden aus offiziellen Cloud-Images aufgebaut. Im beschriebenen Ablauf wird zunächst eine Basis-Vorlage vorbereitet, die den QEMU-Guest-Agent enthält. Er ermöglicht Proxmox unter anderem, Informationen aus dem Gast abzurufen.
Diese Vorbereitung ist ein eigener Schritt. Die Basis muss neu erstellt werden, wenn sich das zugrunde liegende Image oder die Vorbereitung ändert.
Für die regelmäßigen Builds klont Packer anschließend diese Vorlage mit dem Builder proxmox-clone. Nach dem erfolgreichen Cloud-Init-Lauf folgen Updates, Grundkonfiguration und Bereinigung.
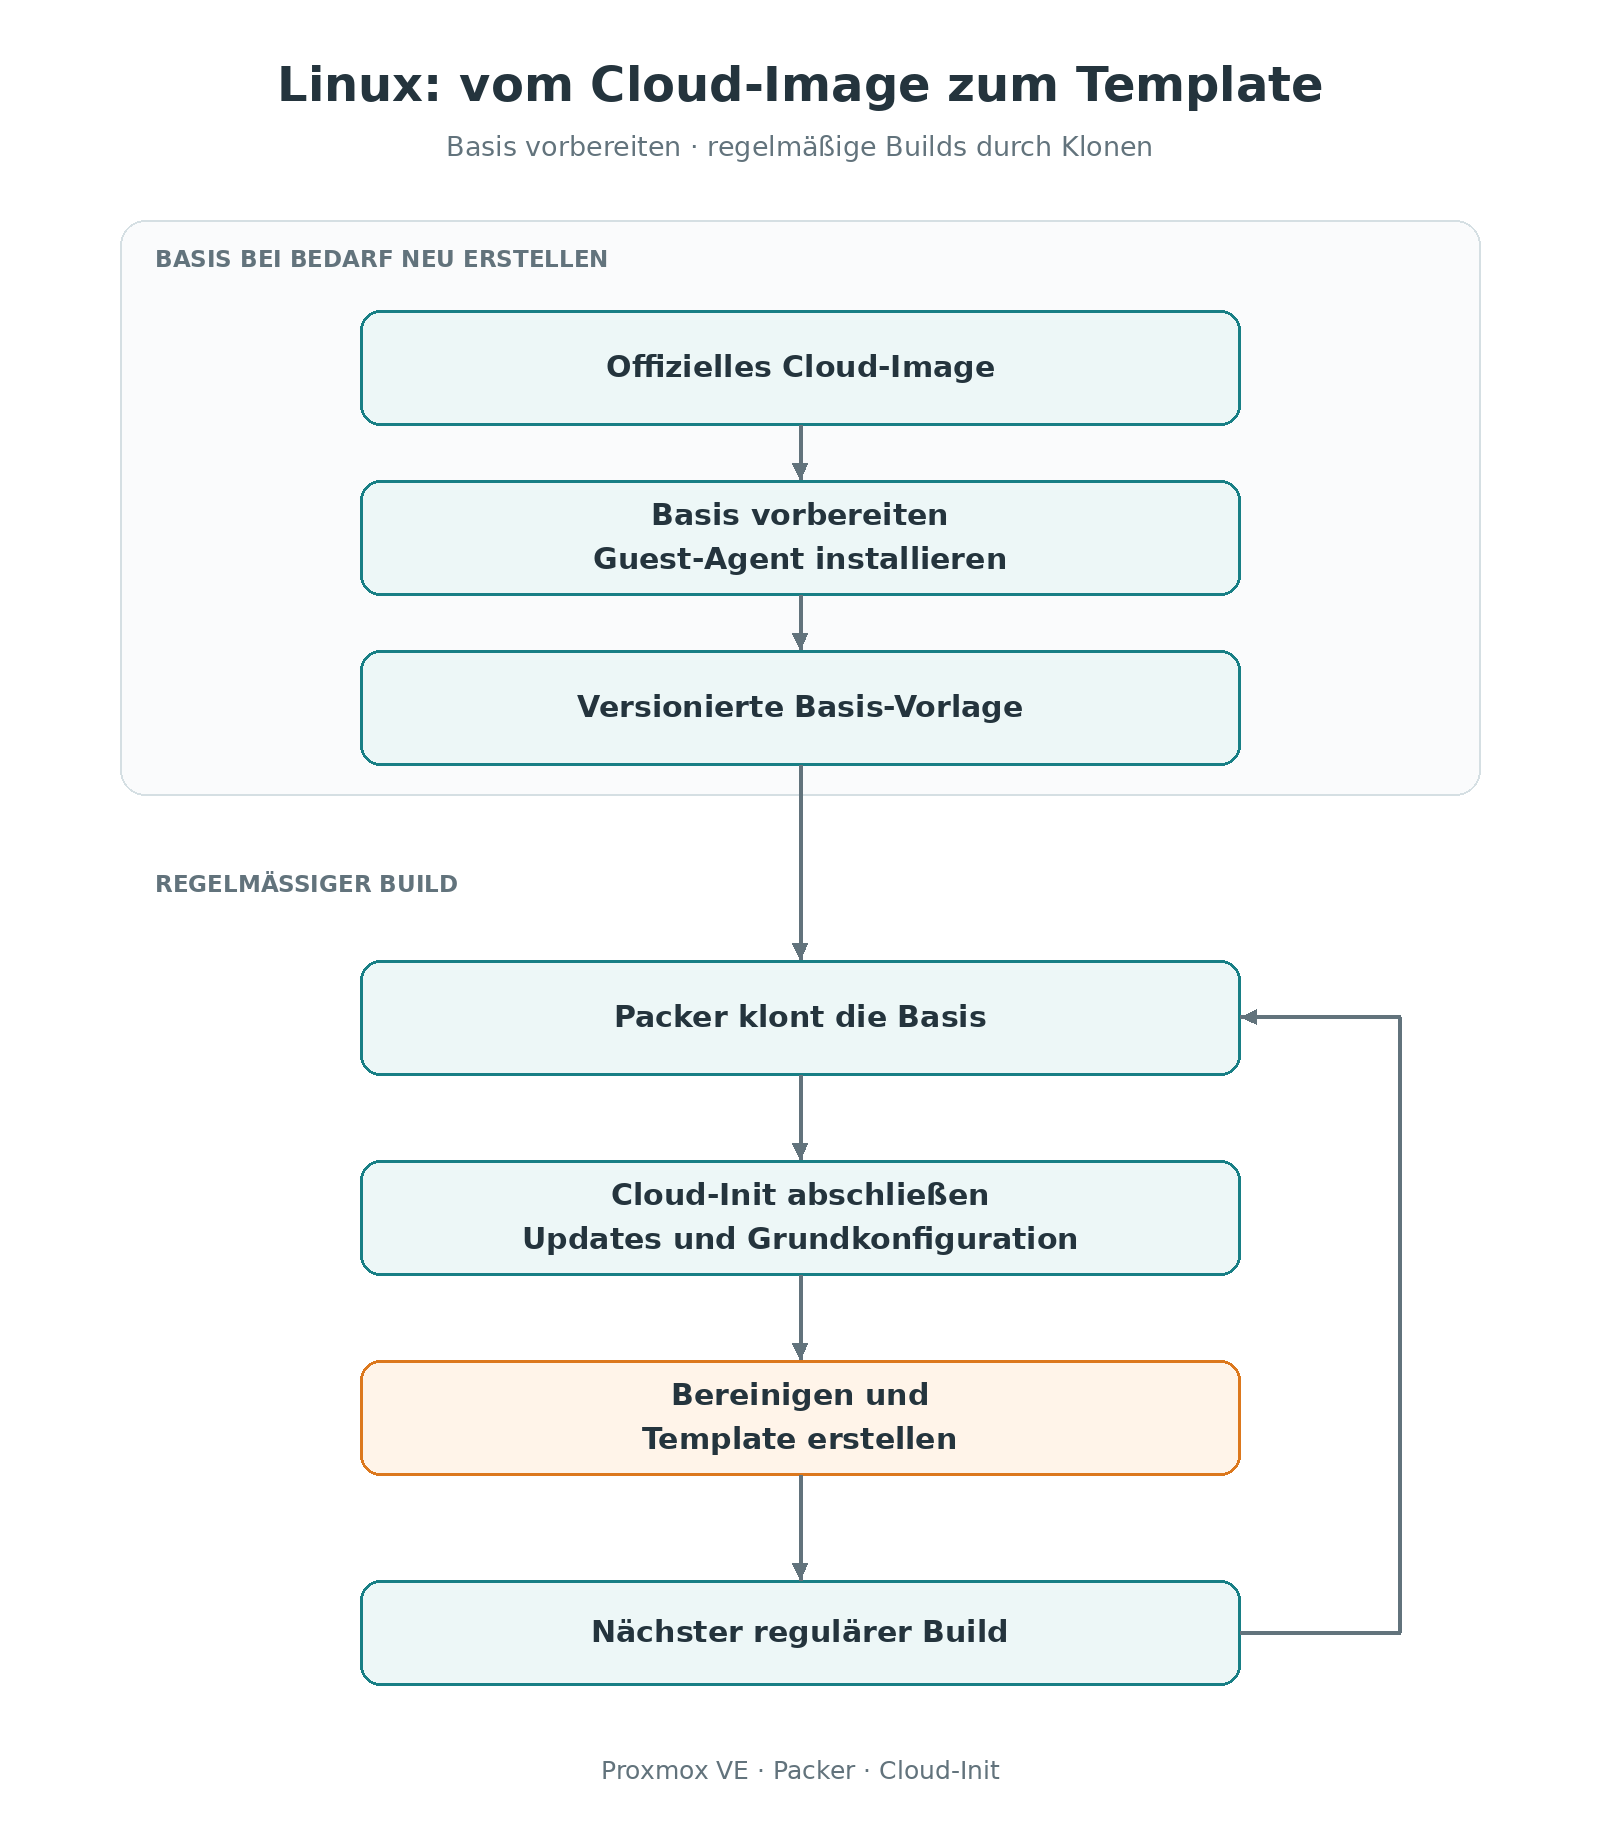
Der Vorteil: Die regelmäßige Pipeline beginnt mit einer bereits startfähigen Vorlage. Sie muss nicht bei jedem Lauf eine vollständige Betriebssysteminstallation durchführen.
Wichtig sind dabei klare Übergänge. Eine erreichbare SSH-Verbindung bedeutet noch nicht, dass Cloud-Init abgeschlossen ist. Die Provisionierung wartet deshalb auf dessen Abschluss, bevor sie beispielsweise Paketoperationen startet. Erforderliche Neustarts müssen ebenfalls ausdrücklich eingeplant werden.
Windows: unbeaufsichtigt vom ISO zum Template
Windows wird in diesem Projekt direkt aus der Installations-ISO aufgebaut. Eine generierte autounattend.xml steuert die unbeaufsichtigte Installation. Eine zusätzliche CD enthält die Antwortdatei, Treiber und Skripte für die Erstkonfiguration.
Bei einer VM mit VirtIO-Speichercontroller braucht Windows Setup den passenden Treiber, um die virtuelle Festplatte zu erkennen. Dafür wird der von Setup unterstützte Ordner $WinPEDriver$ auf dem Installationsmedium genutzt. Setup durchsucht diesen Ordner nach Treiberpaketen.
Das Projekt bereitet die benötigten Dateien aus dem offiziellen virtio-win.iso vor. Dabei werden die zur jeweiligen Windows-Version passenden Pakete mitsamt ihren referenzierten Dateien übernommen.
Nach der Installation richtet ein PowerShell-Skript die Voraussetzungen für die weitere Provisionierung ein: VirtIO-Komponenten, QEMU-Guest-Agent, OpenSSH und die erforderlichen Firewall-Regeln.
Gerade diese Erstkonfiguration braucht Geduld: Treiberinstallation, Netzwerk und Dienste sind nicht gleichzeitig verfügbar. Wiederholungen, Zeitlimits und Protokolle sorgen dafür, dass Fehler nachvollziehbar bleiben. Ein abgelaufenes Zeitlimit muss den Build kontrolliert scheitern lassen, statt ein unvollständig vorbereitetes Template zu erzeugen.
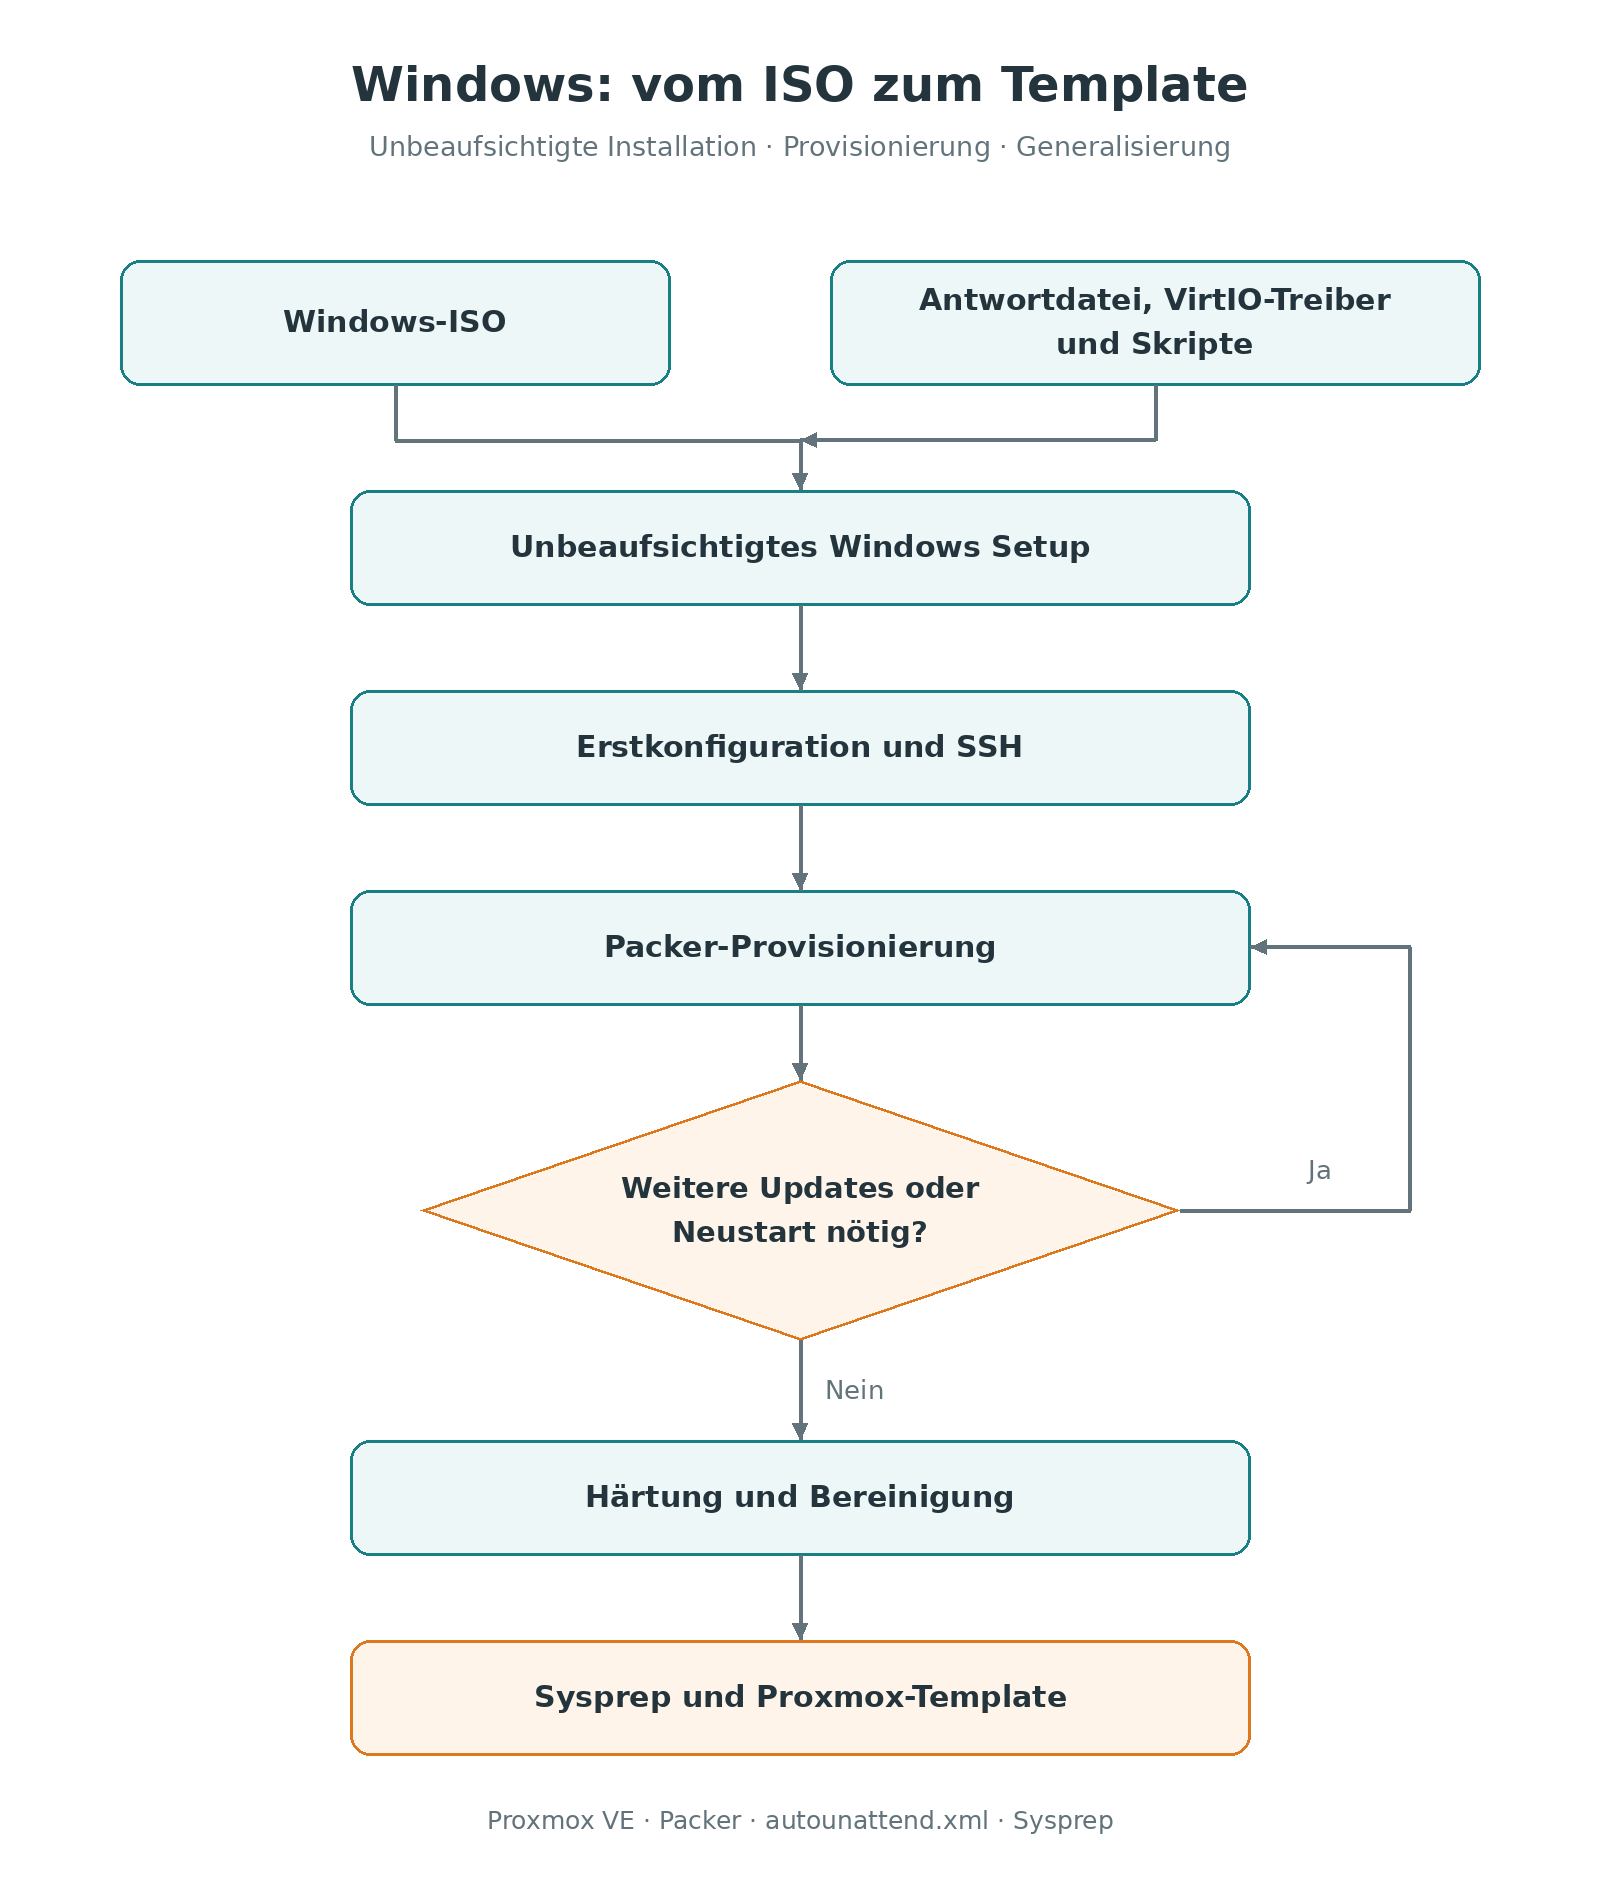
Die optionalen Windows Updates werden im beschriebenen Aufbau über einen lokalen Scheduled Task unter SYSTEM ausgeführt. Packer stößt den Vorgang an und wartet auf dessen Ergebnis. So bleibt die Update-Ausführung vom Kontext der SSH-Anmeldung getrennt.
Am Ende generalisiert Sysprep die Installation. Der VM-Modus /mode:vm ist für die Wiederverwendung mit entsprechend passendem virtuellen Hardwareprofil gedacht. Controller- und Gerätemodelle gehören damit zur Template-Definition und sollten beim späteren Klonen konsistent bleiben. Auch das Beenden von Sysprep und das anschließende Stoppen der VM müssen mit dem Packer-Builder abgestimmt sein.
Sicherheit gehört in den Build
Schon die Standardvorlagen erhalten eine grundlegende Härtung. Dazu gehören definierte TLS-Einstellungen, eine bewusste Auswahl aktivierter Dienste und die Bereinigung von Build-Artefakten.
Die SCHANNEL-Konfiguration muss zur Windows-Version passen: TLS 1.2 bildet die gemeinsame Grundlage der hier genannten Serverversionen. TLS 1.3 wird ab Windows Server 2022 unterstützt; zusätzliche Registry-Einträge machen Windows Server 2019 nicht TLS-1.3-fähig.
Für weitergehende Anforderungen wird die CIS-Variante separat gebaut:
make win2022 CLUSTER=standort-a
make win2022-cis CLUSTER=standort-a
Beide Varianten besitzen eigene Namen und VMIDs. Dadurch lassen sich Anwendungen gezielt gegen die zusätzliche Baseline testen und Ausnahmen nachvollziehbar behandeln.
Eine kuratierte Baseline ist dabei kein automatischer Nachweis vollständiger CIS-Konformität. Dafür müssen die angewendeten Einstellungen, begründete Abweichungen und das tatsächlich gebaute System geprüft werden. Der Provisioner-Code beschreibt die Absicht; die Prüfung des fertigen Templates zeigt das Ergebnis.
Jeder Klon braucht eine eigene Identität
Ein Template darf keine gemeinsam genutzten Maschinenidentitäten an seine Klone weitergeben. Zur abschließenden Bereinigung gehören deshalb unter anderem SSH-Host-Keys und Cloud-Init-Zustand. Unter Windows übernimmt Sysprep die Betriebssystemgeneralisierung; zusätzliche Komponenten wie OpenSSH benötigen ihre eigene Bereinigung.
Beim Ausrollen erhalten die VMs ihre individuellen Einstellungen über Cloud-Init beziehungsweise Cloudbase-Init: Rechnername, Netzwerk, Zugangsdaten und weitere Konfiguration.
Build-Zugangsdaten sind nur für die Erstellung vorgesehen. Ihre Ablösung muss Bestandteil der Bereinigung oder der verpflichtenden Erststart-Konfiguration sein. Auch generierte Antwortdateien, temporäre Medien und Protokolle müssen bei der Behandlung von Secrets berücksichtigt werden.
Dieselbe Pipeline lokal und in der CI
Gitea Actions ergänzt die lokalen Build-Befehle um automatisierte Prüfungen. Ein Check-Workflow kontrolliert Formatierung und validiert die Packer-Definitionen. Ein separater Build-Workflow lässt sich gezielt für ein Template und einen Cluster starten.
Beide Wege verwenden dieselben Skripte und Make-Ziele. Eine Änderung wird damit dort geprüft, wo sie später auch ausgeführt wird.
Syntaxprüfung allein reicht allerdings nicht: Erst ein erfolgreicher Build zeigt, ob Installation, Treiber, Neustarts und Generalisierung zusammen funktionieren. Eine Test-VM aus dem fertigen Template prüft zusätzlich, ob der erste Start klappt und individuelle Einstellungen korrekt übernommen werden.
Auch im KMU: mehr Zeit für produktive Arbeit
Reproduzierbare Templates sind auch mit einem kleinen IT-Team umsetzbar. Dafür braucht es keine eigene Plattformabteilung: Ein Git-Repository, Packer, Skripte und ein Rechner oder Runner mit Zugriff auf Proxmox reichen als Ausgangspunkt. Die vorhandene Virtualisierungsumgebung kann die temporären Build-VMs bereitstellen. Zunächst lässt sich der Prozess lokal starten; eine CI-Pipeline kann später hinzukommen.
Gerade im KMU ist die verfügbare Arbeitszeit oft die knappste Ressource. Dasselbe Team betreut Server, Netzwerk, Support und Projekte. Jede wiederholte Installation und jede nachträgliche Suche nach einer undokumentierten Einstellung bindet Zeit, die für den produktiven Betrieb, Sicherheitsmaßnahmen und die Weiterentwicklung fehlt. Eine automatisierte Pipeline übernimmt einen Teil dieser Routine und macht den Ablauf auch für Vertretungen nachvollziehbar.
Die Automatisierung kostet zunächst Zeit: Skripte müssen erstellt, Fehler behandelt und fertige Templates geprüft werden. Auch danach bleibt Pflege nötig. Der Nutzen entsteht durch die Wiederverwendung: Eine einmal geprüfte Änderung kann in weitere Builds einfließen, statt auf jedem Template erneut von Hand umgesetzt zu werden. Sinnvoll ist deshalb ein kleiner Einstieg mit einem häufig verwendeten Betriebssystem und einer überschaubaren Grundkonfiguration.
Auch die technischen Ressourcen lassen sich begrenzen. Build-VMs benötigen vorübergehend CPU, RAM und Storage; Windows Updates können diese Ressourcen länger beanspruchen. Serielle Builds, geplante Zeitfenster und die Bereinigung temporärer VMs halten die zusätzliche Last kontrollierbar. Eine kurze oder vollständig automatisierte Build-Zeit ist dabei nicht mit eingesparter Arbeitszeit gleichzusetzen: Entscheidend ist, wie viel aktive Betreuung und Nacharbeit entfällt.
Der Gewinn liegt damit vor allem in der Entlastung des Teams. Während ein Build läuft, müssen Administratoren nicht jeden Installationsschritt begleiten. Sie können sich um Störungen, Anwendungen und Verbesserungen kümmern, die dem Unternehmen unmittelbar helfen. Ob sich der Ansatz lohnt, lässt sich an der eingesparten Handarbeit, der notwendigen Pflege und der Zahl wiederkehrender Bereitstellungen beurteilen.
Ein Template ist ein nachvollziehbares Build-Ergebnis
Aus der manuellen Pflege wird ein definierter Prozess. Änderungen sind sichtbar, Builds wiederholbar und unterschiedliche Standorte verwenden dieselbe Grundlage.
Für den Betrieb zählt dabei mehr als ein grüner Pipeline-Status: Zum Template gehören seine Herkunft, der verwendete Code und die Prüfung eines daraus erzeugten Klons. Damit lässt sich später erklären, was ausgeliefert wurde – und bei Bedarf gezielt neu bauen.
Ausblick: die Geburt einer Maschine mit OpenTofu und Ansible
Mit dem fertigen Template ist die Grundlage gelegt. Der nächste Schritt ist, auch die Bereitstellung einer konkreten Maschine aus Code zu beschreiben: von der VM-Konfiguration bis zum betriebsbereiten Dienst.
Dabei ergänzen sich die Werkzeuge mit klaren Aufgaben:
| Werkzeug | Aufgabe bei der Bereitstellung |
|---|---|
| Packer | Baut und prüft das allgemeine Betriebssystem-Template. |
| Terraform oder OpenTofu | Erstellt die VM über einen geeigneten Proxmox-Provider und definiert etwa CPU, RAM, Disks und Netzwerkanbindung. |
| Cloud-Init oder Cloudbase-Init | Übernimmt beim ersten Start die unterstützten individuellen Einstellungen, etwa Rechnername, Netzwerk und Zugang. |
| Ansible | Konfiguriert die Rolle der Maschine: Dienste, Anwendungen, Monitoring und weitere betriebliche Einstellungen. |
Ein neuer Server beginnt dann beispielsweise mit einer Definition: Name, Template-Version, Ressourcen, VLAN und gewünschte Rolle. Terraform beziehungsweise OpenTofu plant die Infrastrukturänderung und setzt sie um. Nach dem ersten Start wartet die Pipeline auf den Abschluss der Initialisierung und auf einen erreichbaren Administrationszugang. Anschließend erhält Ansible die Verbindungsdaten über ein erzeugtes oder dynamisches Inventory und führt die passenden Rollen aus.
Aus einem allgemeinen Linux-Template kann so ein Webserver, Monitoring-System oder Datenbankserver entstehen. Das Template enthält die gemeinsame Basis; die konkrete Aufgabe wird bei der Bereitstellung ergänzt. Das vermeidet eine eigene Template-Variante für jede einzelne Anwendung.
Die Zuständigkeiten sollten dabei eindeutig bleiben: Terraform beziehungsweise OpenTofu verwaltet die virtuelle Infrastruktur, Ansible die Konfiguration innerhalb des Gasts. Cloud-Init stellt die Voraussetzungen für den ersten Zugriff her. Einstellungen, die später Ansible verwaltet, sollten nicht gleichzeitig von mehreren Werkzeugen fortlaufend überschrieben werden.
Terraform und OpenTofu benötigen dafür einen zuverlässig gespeicherten State, der die Definitionen den tatsächlich verwalteten Ressourcen zuordnet. Für die gemeinsame Nutzung gehört er in ein geeignetes Backend mit Zugriffsschutz und Sperrmechanismus. Vor Änderungen wird der Plan geprüft; bei wichtigen VMs können ergänzende Schutzmechanismen das versehentliche Löschen erschweren.
Ansible bleibt auch nach der „Geburt“ der Maschine nützlich. Mit geeigneten Modulen und sauber aufgebauten Rollen lassen sich Einstellungen wiederholt auf den gewünschten Zustand bringen. So wird aus der einmaligen Provisionierung eine pflegbare Konfiguration. Ob der neue Server tatsächlich einsatzbereit ist, zeigen abschließende Prüfungen von Diensten, Erreichbarkeit und Monitoring.
Gerade für kleine Teams entsteht daraus ein durchgängiger Ablauf: Eine Maschine wird beschrieben, automatisch bereitgestellt und überprüft. Wiederkehrende Handarbeit nimmt ab, während ihre Herkunft und Konfiguration nachvollziehbar bleiben.